巨大AIを1体で動かすより、得意な2体に分けた — 3万候補を48時間で38件まで絞った材料研究
【科学・AI】連載・AI・イノベ中国【科学・素材化学】【経済・生成AI】
#MatBrain#材料探索#AIエージェント#結晶材料#窒素固定触媒#自動実験#専門モデル
目次
巨大AIを1体で動かすより、得意な2体に分けた — 3万候補を48時間で38件まで絞った材料研究
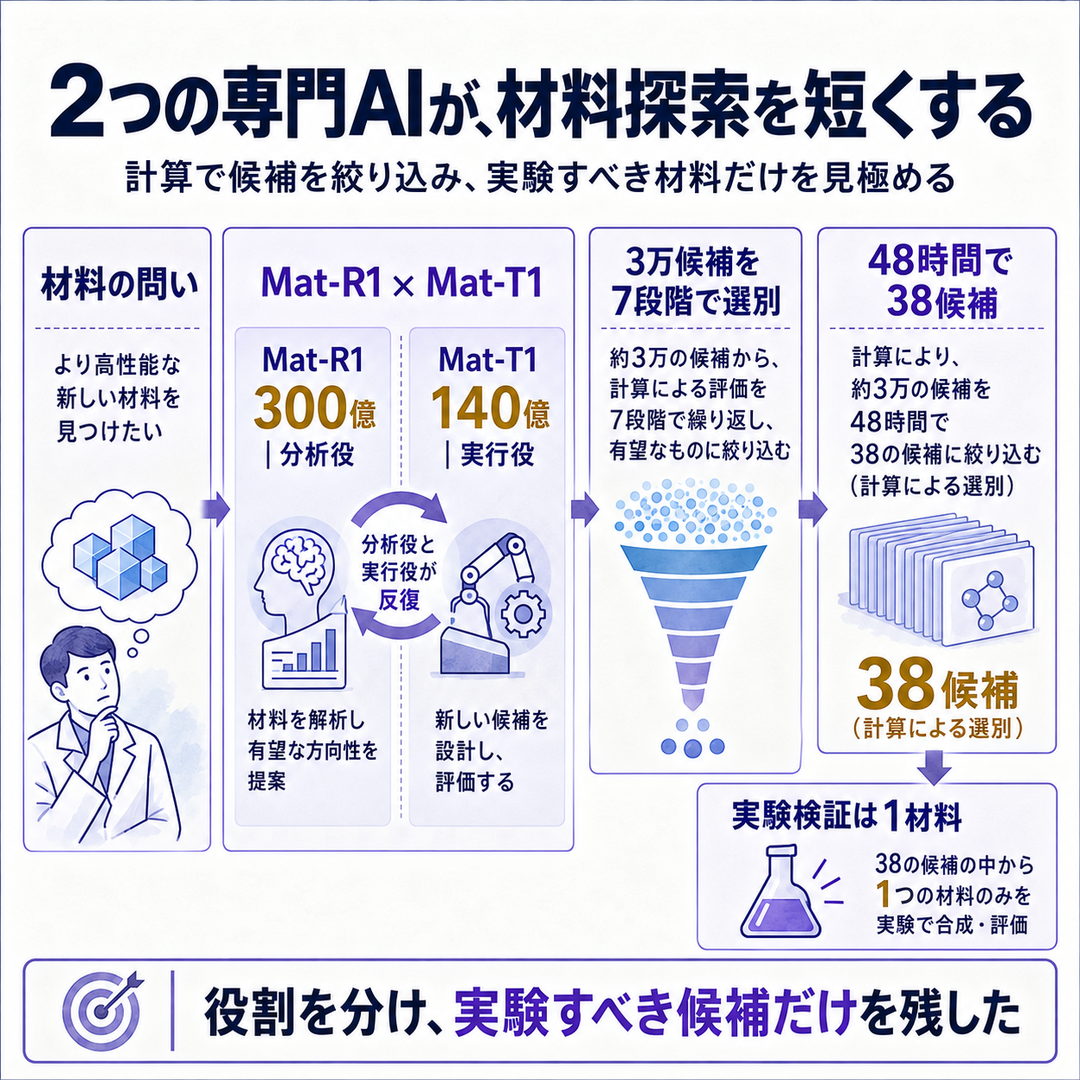
AIを大きくする競争とは逆に、材料研究では「考える役」と「道具を動かす役」を分ける設計が成果を出しました。
中国科学院深圳先進技術研究院などのMatBrainは、3万の結晶候補を48時間で38件に絞り、うち1材料を実験で合成しました。
速さの核心は、1体に全部を覚えさせなかったことです。
300億と140億の2モデルが、3万候補を38件へ絞った
**MatBrainは、科学判断と作業手順を別々のAIへ任せます。
**研究成果は2026年9月10日、Nature Machine Intelligenceに掲載されました。
分析を担うMat-R1は300億パラメータ、計算ツールの選択と実行を担うMat-T1は140億パラメータです。
Mat-R1は、結晶構造、物性、合成経路を読み解く「材料の専門家」に当たります。
Mat-T1は、材料データベースを検索し、構造生成や第一原理計算(原子の性質から物性を計算する方法)のソフトを順番に呼び出す「実験計画の実行役」です。
1回で答えを出さず、実行結果を分析役へ戻し、次の作業を決めます。
学習には約25万2,000件の材料分野の指示データと、2万件の複雑な研究課題が使われました。
公開原稿によると、一般用途の大規模モデルより材料予測の総合精度が66%高く、必要なハードウェアは95%以上少ないとしています。
ただし、比較は研究チームが設定した材料タスク上の結果で、一般的な文章能力の優劣を示すものではありません。
実証では、空気中の窒素からアンモニアを作る窒素固定触媒を探索しました。
自然界の窒素酵素を手がかりに、鉄・コバルト・ニッケルとバナジウム、硫黄からなる候補を生成し、3万件を安定性や電子状態など7段階で絞りました。
48時間後に残ったのが38件です。
速さを生んだのは、知識量より役割分担だった
**道具を選ぶ仕事と、結果の意味を考える仕事では、AIに求める性質が違います。
**ツール操作は、正しい名前と入力形式を守り、失敗時に別の手順を試す力が要ります。
科学判断は、出力値を物理や化学の知識と結び、候補を捨てる理由を説明する力が要ります。
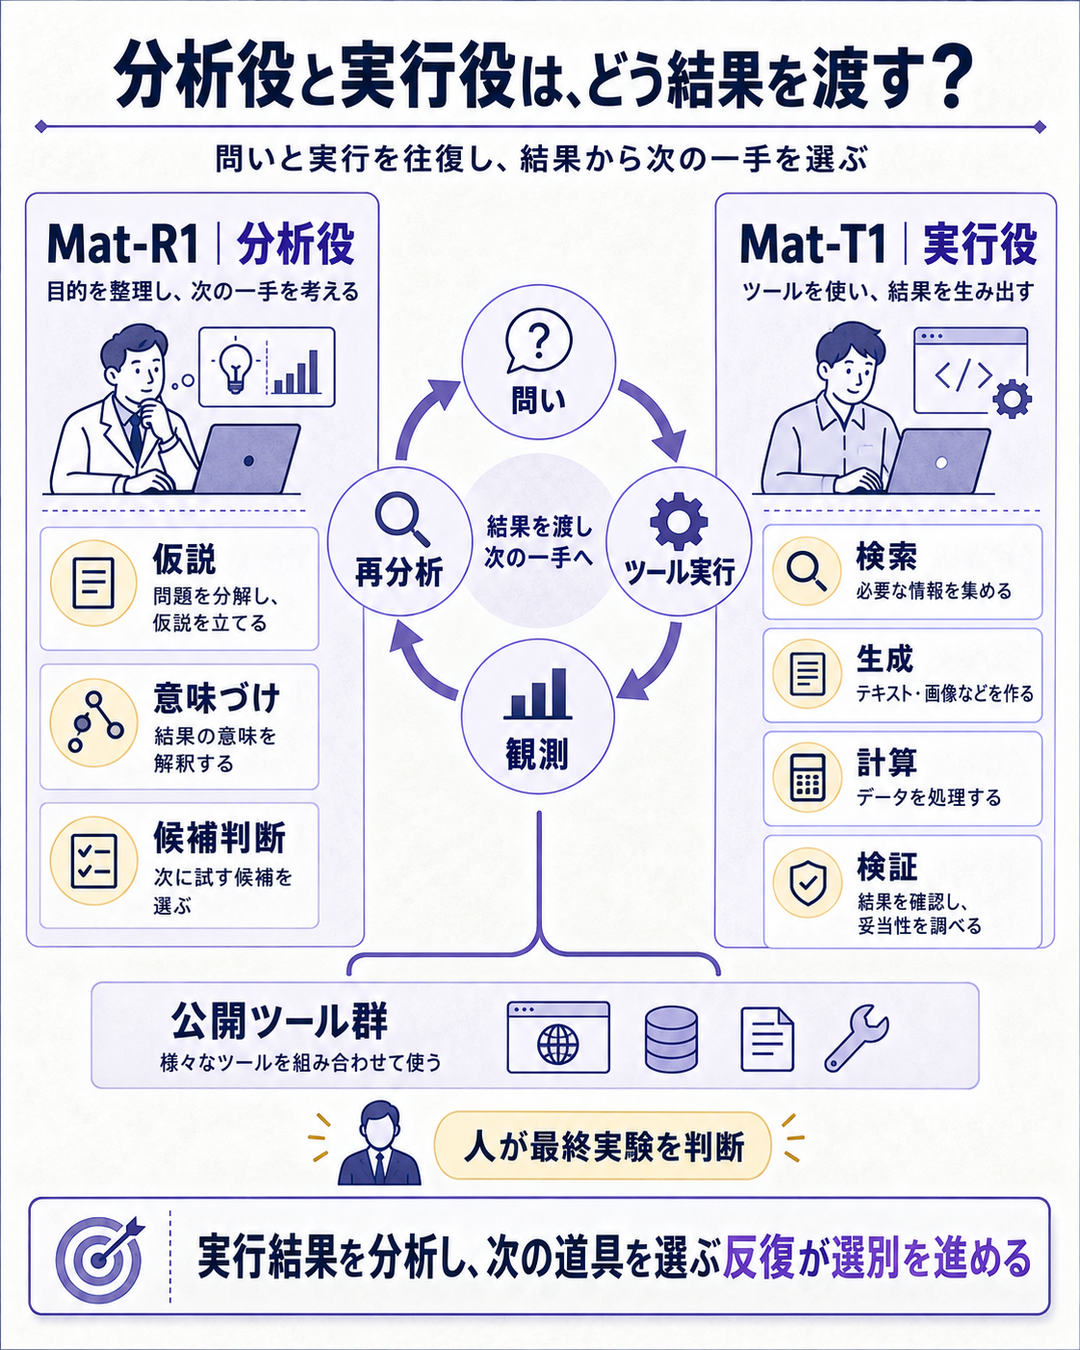
1体のモデルに両方を持たせると、道具を確実に呼ぶための狭い判断と、仮説を広く探す判断が衝突します。
MatBrainは出力のばらつきを調べ、ツール計画と分析推論で異なる分布が現れることを示しました。
研究チームは、役割を分ける根拠の一つにしています。
公開コードには、構造検索、物性予測、結晶解析、化学チェック、合成経路などのツール群が含まれます。
一方、学習済みのモデル重みと完全な訓練データは公開されていません。
コードが見えることと、第三者が同じ性能をすぐ再現できることは別です。
38件が「発見済み」ではない点が重要になる
**計算で有望な候補と、実験で使える材料の間には大きな段差があります。
**38件のうち、研究チームが実験検証に選んだのはCoV4S8という1材料です。
X線回折などで結晶構造を確認し、窒素からアンモニアを作る反応を測りました。
アンモニア生成量の最大値は、触媒1mg当たり1時間に34.6µgでした。
ファラデー効率(流した電気のうち目的反応に使われた割合)の最大値は4.3%で、20時間の試験でも電流を維持したと報告しています。
対照実験では、背景汚染は総生成量の3%未満でした。
これは「AIが38個の新材料を発明し、全部使えると証明した」という成果ではありません。
3万件を、実験する価値がある38件へ狭め、さらに1件で合成と機能を確かめた成果です。
研究開発で高くつくのは、候補を数多く出すことより、設備と人の時間をどの候補に使うかを決める部分です。
GNoMEとA-Labの間をつなぐ設計
**材料AIの競争は、候補数から「仮説、計算、実験をどうつなぐか」へ移っています。
**Google DeepMindのGNoMEは2023年、220万件の新しい結晶構造を予測し、そのうち38万件を特に安定した候補として公開しました。
規模はMatBrainを大きく上回ります。
同じ年に報告された米Berkeley LabのA-Labは、58の目標から17日間で41の新規化合物を自動合成しました。
GNoMEは広い候補空間を作り、A-Labはロボットで実物を作る側に強みがあります。
MatBrainは、科学仮説を立て、複数の計算道具を動かし、実験候補へ絞る判断層を小型モデルで担いました。
3つの数字は母集団も目標も違うため、220万、41、38だけで性能順位は決められません。
それでも、探索、選別、合成という材料開発の工程が別々のAIと装置に分かれ、接続部分が競争点になっていることは見えます。
研究予算に置くなら、モデル利用料だけでなく、候補1件を捨てるまでの計算時間、実験へ送る比率、合成成功率を追います。
AIが候補を10倍に増やしても、実験設備の処理量が同じなら待ち行列が伸びます。
価値が出るのは、失敗候補を早く安く落とせるときです。
見立てと監視ポイント
**次の評価軸は、48時間という速さより、第三者が同じ漏斗を再現できるかです。**1件の実験成功は設計の可能性を示しますが、産業材料の開発基盤と呼ぶには検証数が足りません。
- 実験検証率 — 38候補のうち、追加で何件を合成でき、予測した物性が再現するか。
- 再現可能性 — 学習済み重み、評価データ、計算条件が公開され、外部研究室でも近い結果になるか。
- 工程全体の費用 — AI計算だけでなく、合成、測定、失敗処理まで含む候補1件当たりの費用が下がるか。
腹落ち確認の問い
材料探索AIの価値を測るとき、生成した候補数より「実験へ送らずに済んだ候補数」が重要になるのはなぜでしょうか。
考え方
候補の生成は計算で大量にできますが、合成と測定には装置、材料、人の時間が要ります。
有望でない候補を計算段階で落とせれば、限られた実験枠を成功確率の高い案件へ振り向けられます。
ただし、絞り込みが厳しすぎて本当に良い材料を捨てていないかを確かめるため、落とした候補の一部も抜き取り検証する必要があります。
出典(一次/二次の切り分け)
- 一次・著者原稿 — Shiほか、arXiv 2604.11540。2モデルの規模、3万候補、38件、48時間、約100倍、ハードウェア要件95%以上削減を直接照合。
- 査読版の書誌 — Nature Machine Intelligence、2026年9月10日掲載。本文ページは認証リダイレクトで取得できず、Jina再試行も不達。掲載日と要旨は検索結果、著者原稿、中国科学院掲載記事で三重照合。
- 公式補足 — 中国科学院掲載の科技日報記事、2026年9月11日。学習データ約25万2,000件、強化学習課題2万件、役割分担を照合。
- 公開実装 — MAIC-SIATのGitHub。ツール群とサンプルデータは公開済みだが、学習済み重みと完全データは含まれないことを確認。
- 独立比較 — Google DeepMindのGNoME公式発表とNatureのA-Lab要約で、220万候補・38万安定候補、58目標中41化合物・17日を照合。
- 反証1パス — 38件は計算候補で、実験検証は1材料です。異なる研究の候補数を単純比較せず、性能主張は研究チームの評価条件に限定しました。
もっと詳しく知りたい人へ
- MatBrainの著者公開原稿 — 2モデルの構造、評価、触媒探索の全体を確認できます
- Nature Machine Intelligence掲載ページ — 査読版の書誌情報と要旨を確認できます
- 中国科学院掲載の科技日報記事 — 学習データ、役割分担、産業応用の説明を読めます
- MatBrain公開リポジトリ — 公開されたツール、サンプルデータ、再現範囲を確認できます
- Google DeepMindのGNoME発表 — 大規模な結晶候補生成との違いを比較できます
- 化学業界基礎ガイド — 新材料が研究から量産へ進む際の化学産業の構造を俯瞰できます
- 情報・通信業業界基礎ガイド — AI基盤とソフトウェア事業の収益構造を確認できます