薬の機密データは渡さず、AIだけ賢くなった — 製薬5社が越えた「共有できない」の壁
【科学・ライフサイエンス】連載・AI・イノベ【科学・AI】米国【経済・新薬】
#創薬AI#連合学習#製薬#機密データ#OpenFold3#データガバナンス
目次
薬の機密データは渡さず、AIだけ賢くなった — 製薬5社が越えた「共有できない」の壁
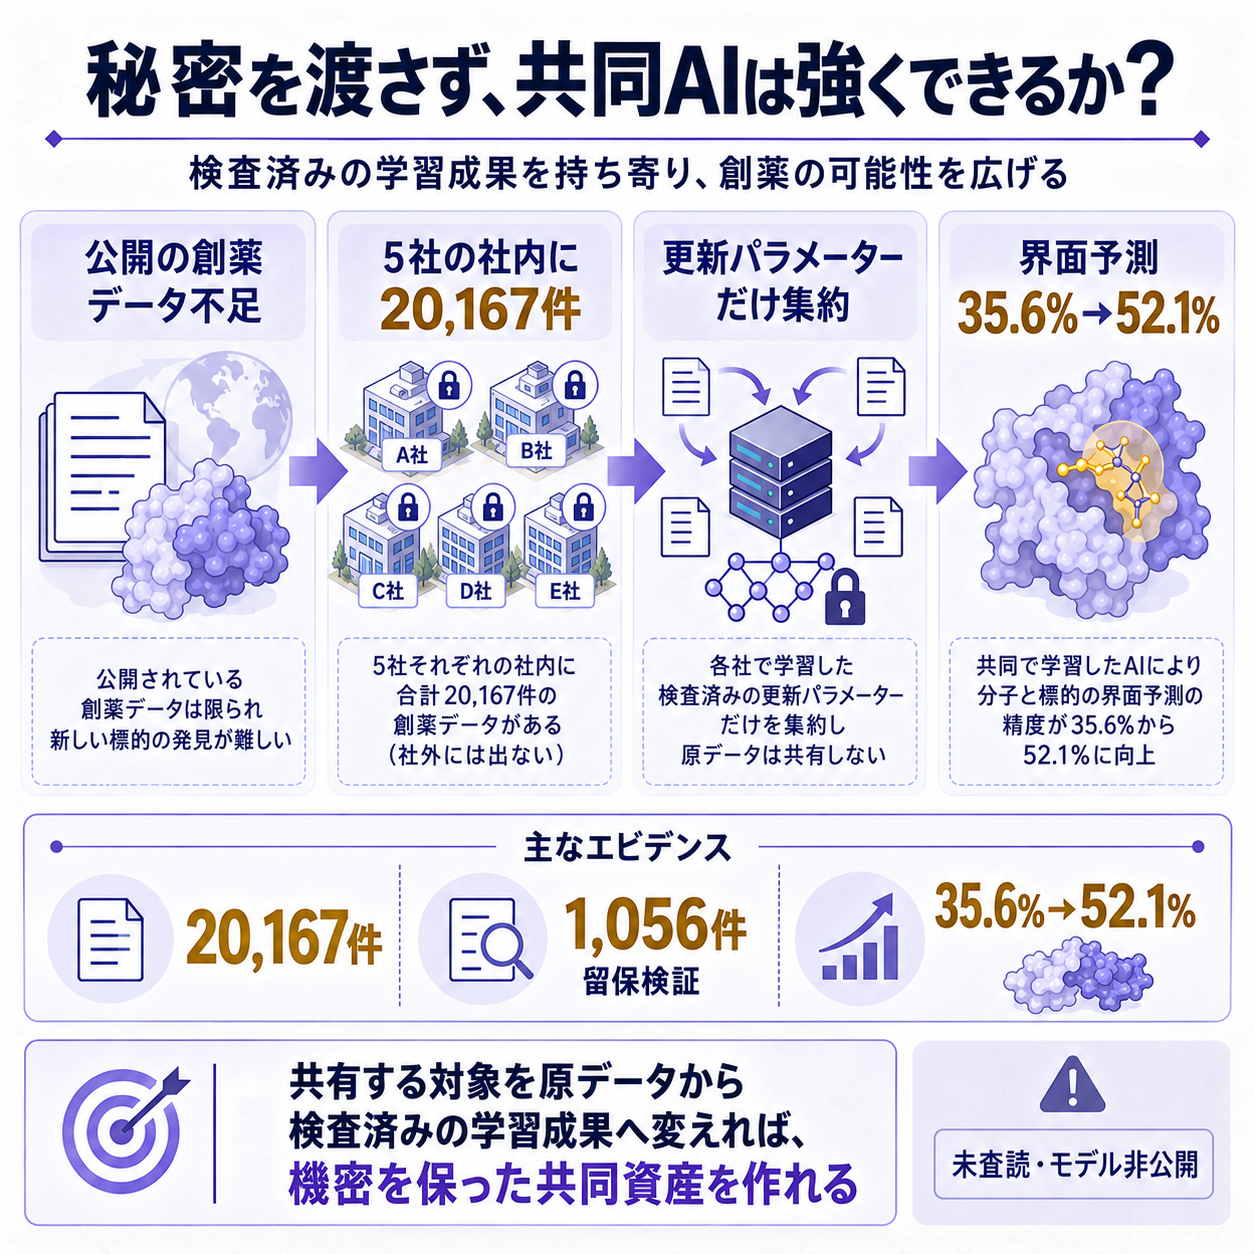
競合する製薬会社が、薬の設計図を互いに見せないまま、1つのAIを共同で強くしました。共有したのは機密データそのものではなく、各社内で学んだモデルの更新分です。
ApherisとAI Structural Biology Network(AISB)は9月14日、AbbVie、Astex Pharmaceuticals、Bristol Myers Squibb、Johnson & Johnson、武田薬品の5社による共同学習の結果を公表しました。
薬候補とたんぱく質がどう結びつくかを予測するAIへ、各社が蓄えた非公開データを使わせています。
2万件を動かさず、正確な予測を半数まで増やした
共同学習で、高品質な界面予測の割合は約3分の1から半数超へ上がりました。 学習に使ったのは、実際の創薬計画から得たたんぱく質・低分子の立体構造20,167件です。
そのうち各社が5%を試験用に取り分け、全モデルを比較できた1,056件で性能を測りました。
たんぱく質と薬候補の接触面を高品質に予測できた割合は、元のOpenFold3 Preview 2で35.6%、共同学習後のAISB-1-Fedで52.1%でした。
薬候補を正しい位置へ置けた割合も28.9%から46.8%へ上がっています。
比較対象の公開モデルBoltz-2は、同じ非公開試験で界面精度40.9%、配置精度36.5%でした。
AISB-1-Fedは両方で約11ポイント上回りました。
ただし「半数で成功」は「薬が半数できる」という意味ではありません。
立体構造予測という創薬工程の一部を測った数字です。
用語の補足
- リガンド — たんぱく質へ結びつく小さな分子です。薬候補も含まれます。
- 共折りたたみ予測 — たんぱく質と薬候補を別々でなく、結びついた立体構造として予測する方法です。
- 連合学習 — データを中央へ集めず、各保有者の環境でモデルを学ばせ、更新情報だけを合成する方法です。
- 留保データ — 学習には使わず、完成後の性能確認だけに残した試験データです。
公開データは多いのに、薬の形は足りなかった
ボトルネックはデータ総数ではなく、創薬で本当に必要な例の薄さでした。 Protein Data Bankには実験で確かめた構造が24万件超あります。
しかし、承認薬か治験中の薬を含むものは約10,600件で、AlphaFold3の学習期限後に増えたものは約3,000件に限られます。
一方、製薬会社は長年の実験で、同じ標的へ少しずつ形を変えた薬候補を何度も当てています。
この連続した記録には「どの変更で結びつき方が変わったか」という濃い学習材料があります。
競争力の源泉なので、公開データベースへ丸ごと出すことはできません。
元モデルへ新しい公開データだけを足した対照モデルも作られました。
それでも非公開データを使った共同モデルのほうが良かったため、公表範囲では「単に新しいデータを学んだから」では説明できません。
公開データの量より、実際の薬づくりに近いデータの質が効いた形です。
データの代わりに、学習の差分を運ぶ
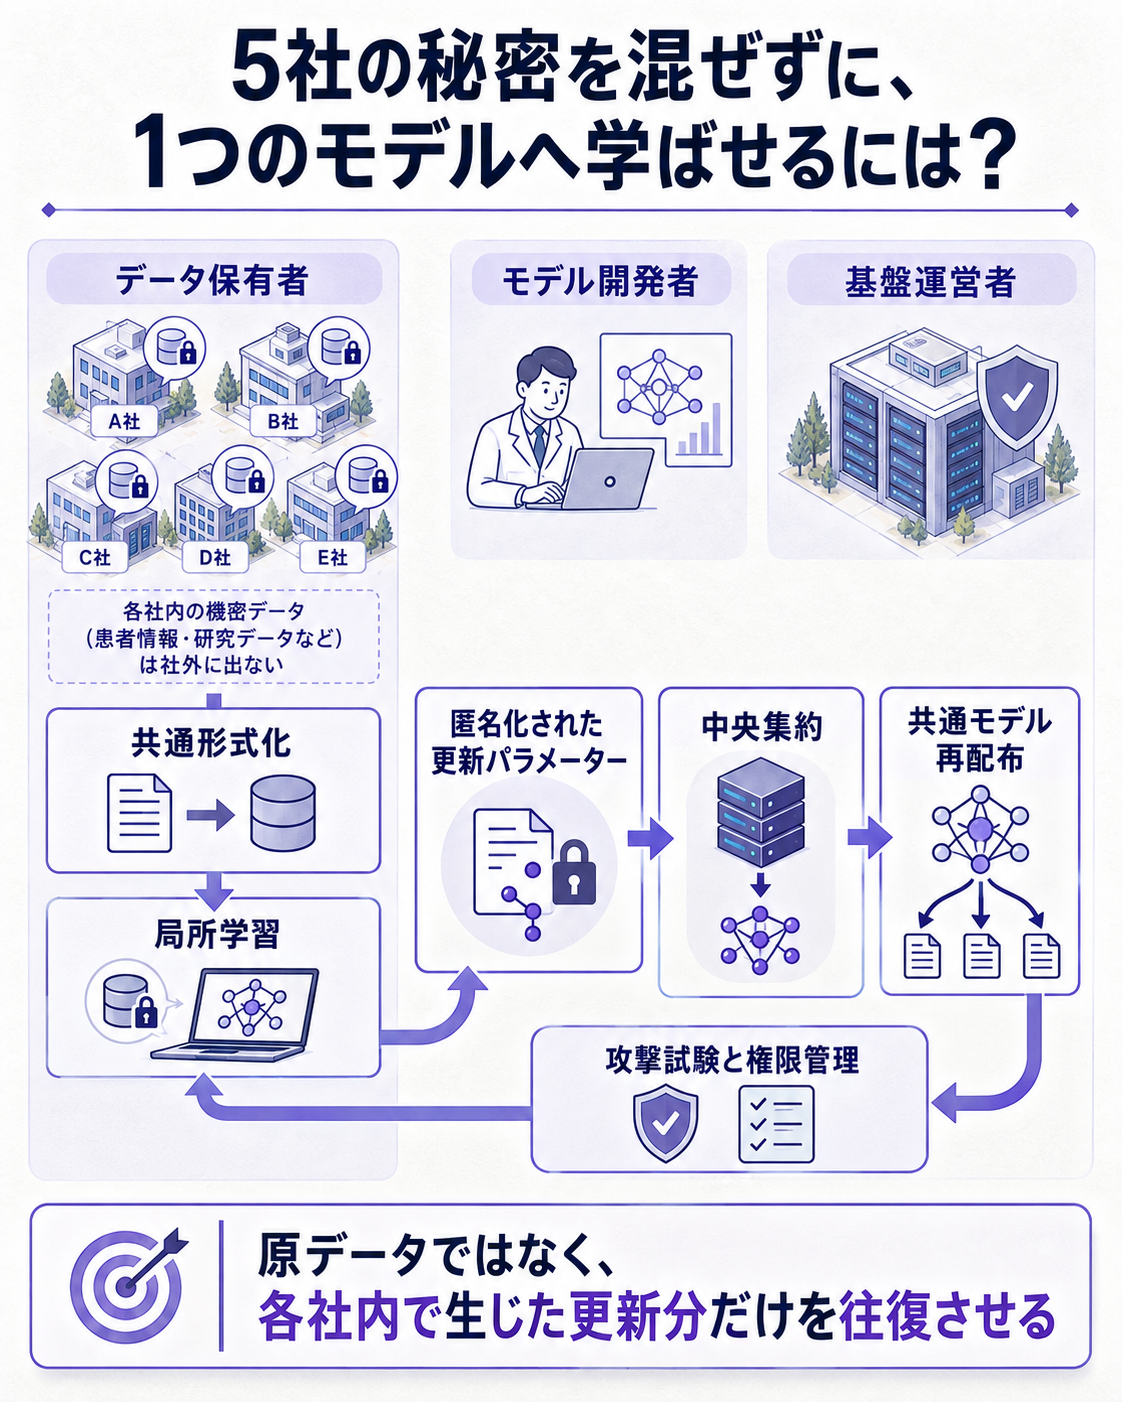
仕組みの核心は、AIをデータのある場所へ送り込むことです。 5社は共通形式へ整えた構造データを、それぞれの社内環境に置きました。
モデルが各社で短時間ずつ学び、更新されたパラメーター(AI内部の調整値)だけを中央の集約機能へ返します。
中央では更新分を平均し、新しい共通モデルを各社へ戻します。これを繰り返しても、化合物の構造、結合データ、実験結果は外へ出ません。役割も、データ保有者、モデル開発者、基盤運営者に分けました。
ただし、ネットワークをつなげば終わる話ではありません。
各社は何十年も別々の形式で構造を保存していました。
分子の記述、結晶の解像度、たんぱく質鎖、接触面のラベルを同じ決まりへ直し、全件を学習処理へ通す予行演習が必要でした。
共同開発の予算は、計算費より整備と統制へ寄る
再現したい企業が先に見積もるべきなのは、GPUの台数よりデータを使える状態にする費用です。 今回は10週間未満で共同モデルへ到達しましたが、その前提に共通スキーマ、参加契約、アクセス権、知的財産の分離、試験方法の合意があります。
予算を置くなら、計算資源、データ整形、法務・セキュリティ、性能評価、運用事務を分けます。
たとえば計算費が当初より2割下がっても、各社ごとの形式変換と承認に人月が膨らめば総額は下がりません。
逆に、共通の検査手順を次のテーマでも使えれば、2回目以降の立ち上げ費は薄まります。
成果配分も重要です。
AISBでは参加者が生まれたモデルを受け取り、既存技術と共同成果の知的財産を契約で分けます。
自社データの件数だけで費用を割ると、希少性や品質の差を拾えません。
提供量、性能への寄与、計算負荷、利用範囲を別々に記録するほうが交渉しやすくなります。
この方式は、銀行の不正検知、工場の故障記録、病院の診療データにも応用できます。
共通点は、単独企業では例が足りず、中央集約は競争・規制上難しいことです。
技術導入の前に「何を外へ出さないか」「何なら共同で持てるか」を契約語に直す必要があります。
成果は大きいが、外部試験はまだ残る
今回の結果は実用に近い一方、独立機関が再現した査読済み研究ではありません。 報告は参加企業と基盤提供者によるもので、学習後のモデルも非公開です。
試験データは学習から外してありますが、同じ5社の計画から来ています。
プロジェクト単位で学習用と試験用を分け、別会社の学習データと似にくい対象を選んだ点は過学習対策になります。
それでも、未知の会社、標的の種類、化学領域で同じ改善幅が出るとは限りません。
Natureも、研究は未査読でモデルを公開していないと明記しています。
プライバシー面では、データ復元と「特定のデータが学習に入ったか」を探る攻撃を試し、5社で意味のある漏えいリスクを見つけなかったと報告しています。
これは検査条件内の結果です。
将来の攻撃や運用ミスまで含めた安全証明ではありません。
見立てと監視ポイント
価値の判定線は、予測精度が研究室の数字から創薬の手戻り削減へ移るかです。 次の3点を追います。
- 完全な外部ベンチマーク — 参加企業と無関係な構造や標的でも、約11ポイントの優位が残るかを見ます。
- 工程KPI — 候補化合物の合成回数、実験不一致率、標的選定から候補決定までの日数が減るかを確認します。
- 2回目の立ち上げ費 — 結合の強さや副作用予測へ広げたとき、共通形式と契約を再利用して準備期間を短くできるかが共同基盤の経済性を決めます。
腹落ち確認の問い
競合5社が原データを一件も交換していないのに、なぜ単独で学習したモデルより共同モデルが良くなったのでしょうか。
考え方
各社の原データは移動しませんが、そこで生じたモデルの更新分には「この種類の構造では予測をどう直すべきか」という学習結果が含まれます。
中央で5社分を合成して戻すと、各社は自社だけでは出会えなかったパターンの影響を受けられます。
価値を生んだのは秘密の公開ではなく、共通形式、更新分の集約、同じ試験条件、知的財産の契約を一体で設計したことです。
もっと詳しく知りたい人へ
- 結果の原文: Apherisの9月14日付報告 — 学習・検証件数、比較指標、データ整形、プライバシー試験、限界まで確認できます
- 独立報道: Natureの科学ニュース — 公開データ不足の背景、未査読・モデル非公開という留保が分かります
- 共同体の構造: AISB Networkの説明 — 参加者、成果の所有、計算とデータの役割分担を確認できます
- 公開モデルの基礎: OpenFold3公式サイト — 共同学習の土台になったモデルと公開創薬AIの位置づけが分かります
- 医薬品業界の全体像: 医薬品業界基礎ガイド — 研究開発費、特許、承認までの長い工程と今回の技術を結びつけられます
- 国内主要社の比較: 医薬品主要プレイヤー比較 — 製薬各社の収益構造と研究開発負担を横断できます
出典(一次/二次の切り分け)
一次で照合したもの
- Apheris・AISBの2026年9月14日付結果報告 — 参加5社、20,167件の学習データ、1,056件の検証、35.6%から52.1%と28.9%から46.8%の改善、Boltz-2との差、データを動かさない学習経路を確認しました。
- AISB Networkの公式説明 — 公開データの構成、参加企業、成果モデルの所有、データ保有者・モデル開発者・基盤運営者の役割分担を確認しました。
反証で残った限界
- Natureの9月14日付報道で主要値を照合しました。結果は未査読でモデルは非公開です。試験は参加5社の留保データをまとめたもので完全な外部試験ではなく、創薬期間、候補薬の成功率、研究開発費が改善した実績はまだ示されていません。プライバシー評価も、将来の全攻撃と運用事故を否定するものではありません。