モデル本体へ侵入せず、能力だけを写し取る — 米3機関が警告した「数百万回の質問」という攻防
【国際・通商】連載・AI・イノベ米国中国【科学・AI】【横断・サイバー】【政治・デジタル政策】【経済・生成AI】
#AI#知識蒸留#モデル抽出#AIセキュリティ#米中技術競争#API#知的財産
目次
モデル本体へ侵入せず、能力だけを写し取る — 米3機関が警告した「数百万回の質問」という攻防
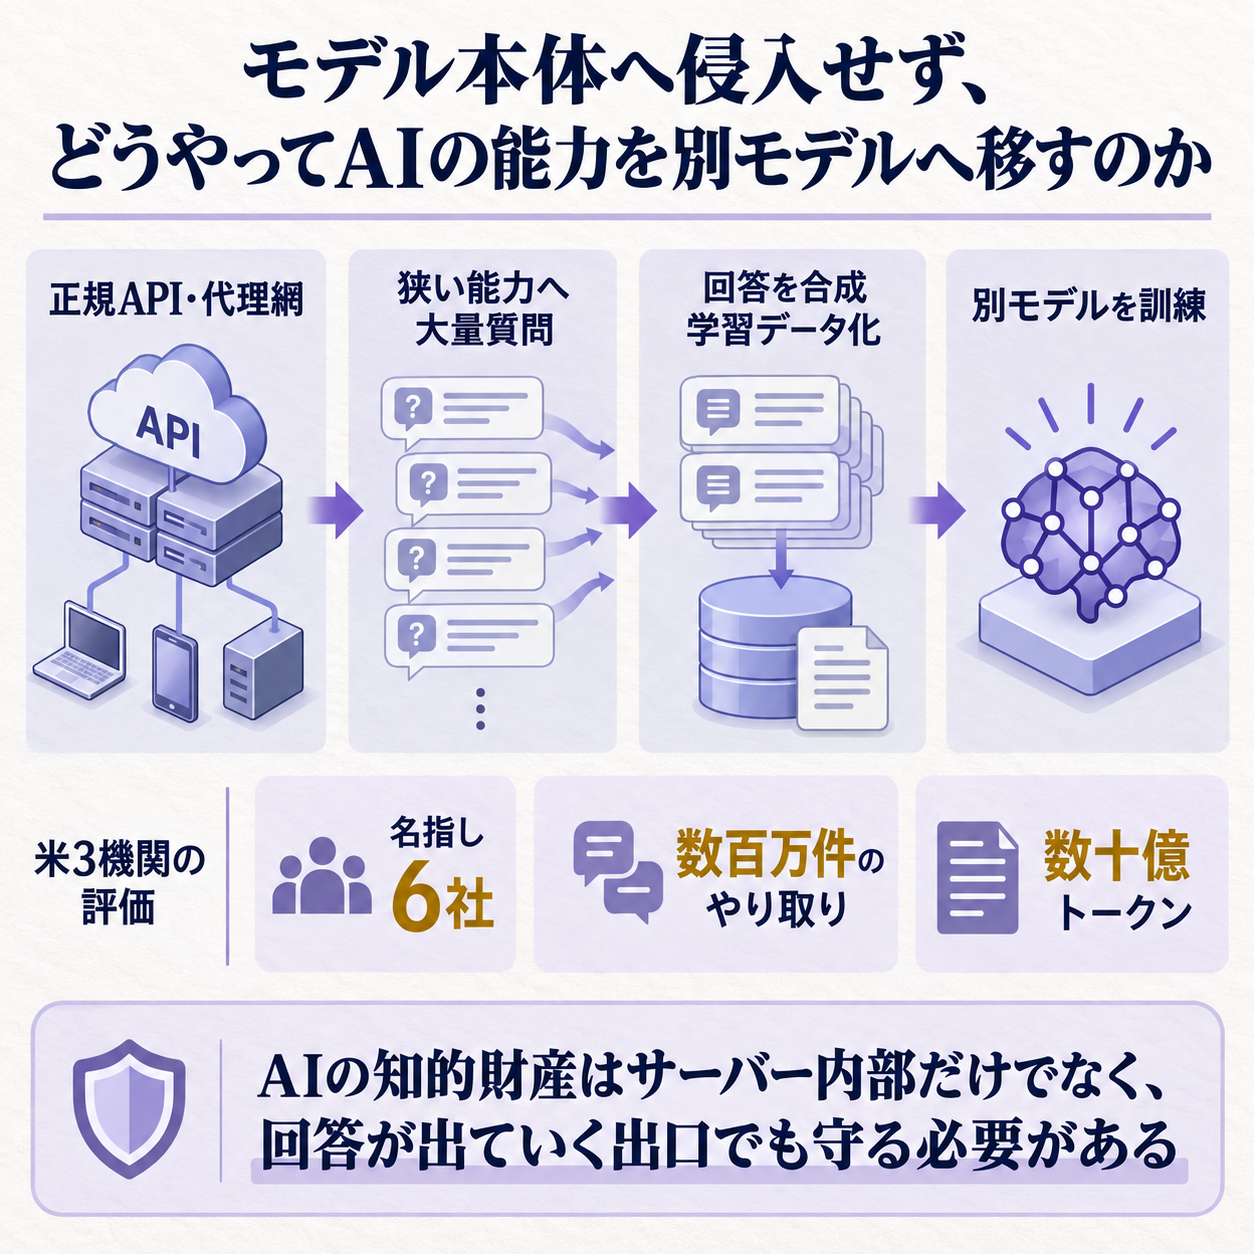
AIの設計図や学習データを盗まなくても、得意な問題を何度も解かせ、その答えを教材にすれば、能力の一部を別のモデルへ移せます。
質問を受け付ける正規の入口が、そのまま知的財産の出口にもなったということです。
米国家安全保障局、サイバーセキュリティ・社会基盤安全保障庁、連邦捜査局は2026年9月8日、18ページの共同勧告を公表しました。
中国拠点のAI企業が米国の先端モデルへ数百万件規模で問い合わせ、知識蒸留に使ったと主張し、AI提供会社へ検知、回答変更、企業間の情報共有を求めています。
ただし、この勧告は司法判断ではありません。
企業名、規模、政府関与は米機関の評価で、中国商務部は9月9日に根拠がないと全面的に否定しました。
技術としての蒸留と、許可なく能力を抽出する行為を分けて読む必要があります。
数百万件の回答が、別のAIの教材になった
米機関は、蒸留が補助作業ではなく対象企業の開発戦略の中核だったと評価しています。 勧告が名指ししたのはDeepSeek、Moonshot AI、Alibaba、MiniMax、StepFun、Z.AIの6社です。
少なくとも2024年末以降、Claude、GPT、Gemini、Grokの各系統から数十億トークン(AIが文章を扱う細かな単位)を数百万件のやり取りで得たとしています。
知識蒸留は、本来は広く使われる中性の技術です。
高性能な「教師モデル」の回答を教材にして、小さく安い「生徒モデル」を訓練します。
開発元が自社モデル同士で行ったり、提供者の許諾を得て行ったりする場合もあります。
争点は、許可、規模、アクセス方法、目的です。
勧告は、地域制限や利用規約を避け、能力の再現を目的に大量取得した点を攻撃と位置付けました。
モデルの重みへ直接触れなくても、回答の傾向、推論の組み方、ツール利用の手順を集めれば、訓練用データを外側から作れます。
Anthropicは2月23日、DeepSeek、Moonshot、MiniMaxによるClaudeへのアクセスを1600万回超、不正アカウントを約2万4000件と公表しました。
そのうちMiniMaxは1300万回超、DeepSeekは15万回超としています。
これはAnthropic自身の検知と帰属で、共同勧告の背景資料にはなっていますが、生ログ全体が第三者へ公開されたわけではありません。
用語の補足
- 知識蒸留 — 高性能な教師モデルの出力を使い、別の生徒モデルへ能力を移す学習方法です。
- モデルの重み — 学習で調整された膨大な数値の集合で、AIの内部状態に当たります。今回の主張は、重みへの直接侵入ではなく出力の収集です。
- 合成学習データ — 人が作った正解集ではなく、別のAIが生成した回答を材料にした訓練データです。
- API集約業者 — 複数のAIサービスへの接続を一つの窓口で販売する事業者です。
正規の入口を、分散した大量取得に使う
一件ずつは普通の利用に見えることが、大規模な抽出を見つけにくくします。 勧告によると、問い合わせは公式API、クラウド経由の接続、第三者の集約業者、代理中継、複数のアカウント群へ分散されました。
中国で「転送站」と呼ばれる灰色市場の代理網も挙げています。
運用側は、地域やアカウント情報を隠し、利用枠が尽きると別経路へ切り替え、料金と処理量を一元管理したとされます。
大量の回答が本物の能力を保っているかを自動評価し、防御側が品質を落とすと別経路へ逃がす仕組みも説明されています。
Anthropicは、ある代理網が同時に2万件超の不正アカウントを管理したと報告しました。
MiniMaxの案件では新モデル公開から24時間以内に対象を切り替え、流量の半分近くを新モデルへ向けたとしています。
勧告も、同じ分野への問い合わせが数千件から数百万件に集中し、数日から数カ月続くことを検知材料に挙げました。
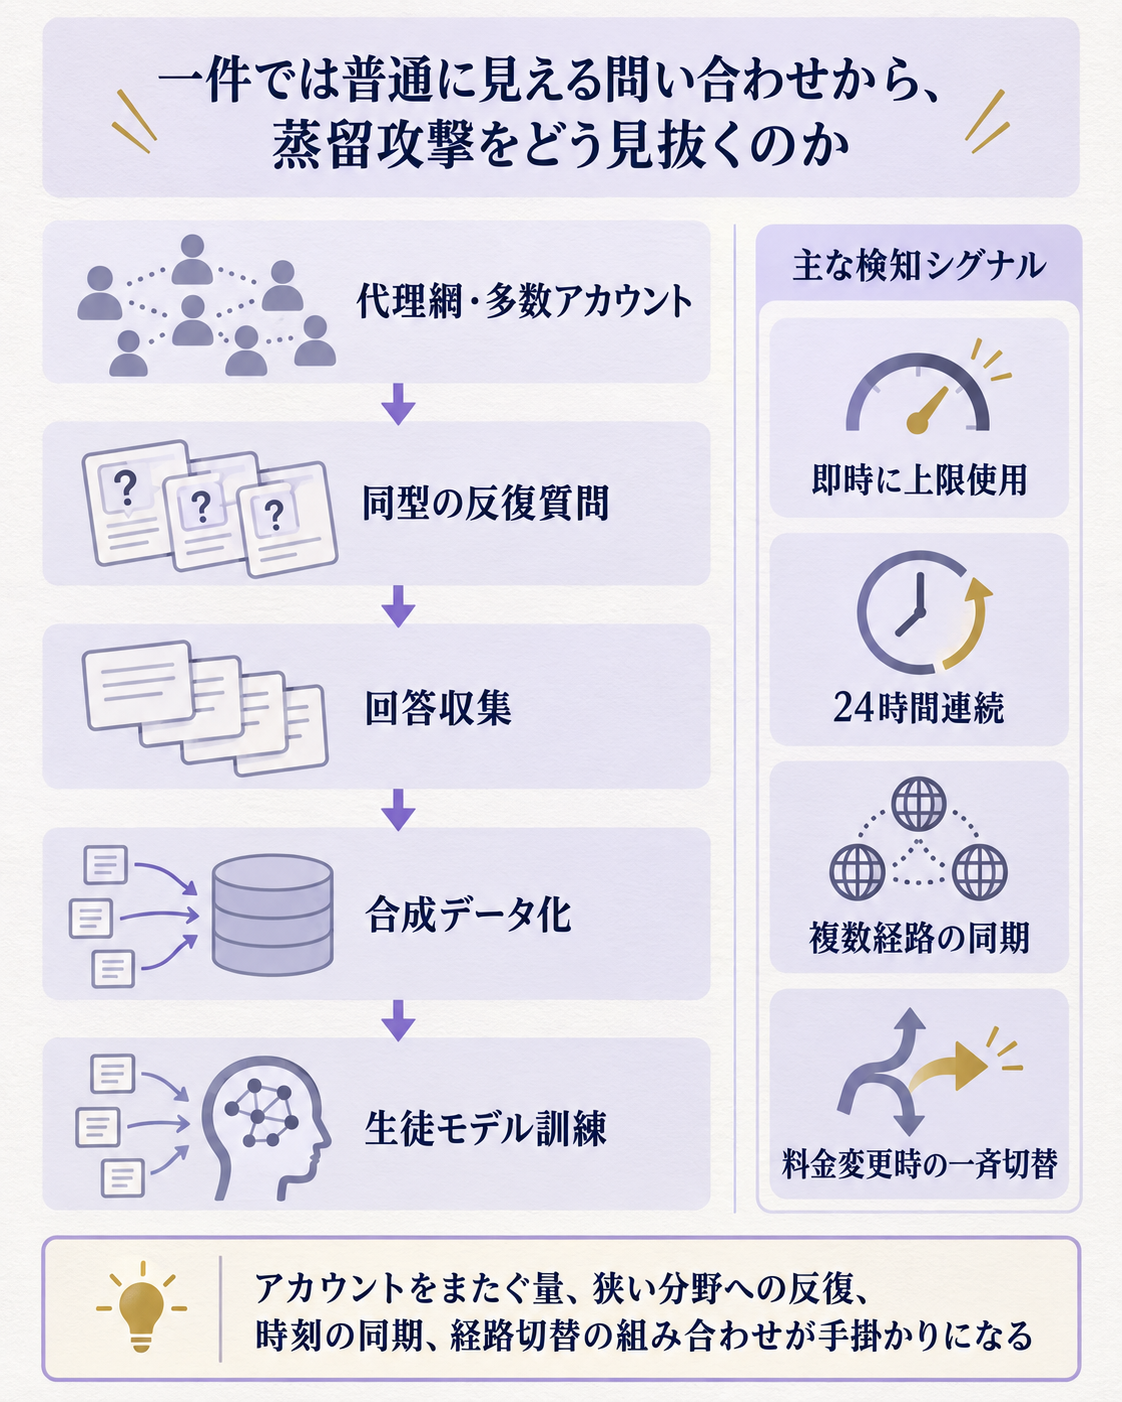
一つの難しい質問だけで悪意は判定できません。
新規アカウントがすぐ利用上限へ達する、24時間休みなく動く、同じ型の質問が複数経路で同期する、料金変更に合わせ一斉に経路を変えるといった組み合わせが手掛かりになります。
守り方は、止めるだけでなく答えを変える段階へ進んだ
共同勧告の新しさは、アクセス遮断だけでなく、疑わしい相手へ返す回答そのものを変えるよう勧めた点です。 即時対応は、行動検知、対象を絞った回答変更、組織をまたぐ情報共有の三つです。
検知では本人確認、アカウント・IPごとの上限、入出力ログ、利用量の立ち上がり方を組み合わせます。
単一のAI会社だけでは分散した動きに見えるため、モデル提供者、クラウド、API集約業者が時刻、量、インフラの指標を突き合わせる必要があります。
回答変更では、推論の深さを抑えたモデルへ切り替える、出力を短くする、差分プライバシー(統計的なノイズで情報を抜きにくくする方法)を使うといった案が示されました。
狙いは、問い合わせを受け付けながら訓練データとしての価値を下げ、抽出側の費用を上げることです。
一方、誤判定すれば正規顧客の品質が見えないまま落ちます。
勧告は、悪質な蒸留だと高い確度で確認した利用者には切替を知らせない一方、安全性研究者や第三者評価者には変更を知らせるよう区別しています。
防御の強さだけでなく、判定権限、異議申立て、品質低下の監査が必要です。
APIの売上と、能力流出の費用を別々に測る
モデル提供会社にとって、高利用量は売上であると同時に、将来の競争力を移す兆候にもなります。 従来の不正対策は盗まれたカード、未払い、アカウント乗っ取りを主に見てきました。
蒸留では料金が払われても、得意能力を再現する教材として使われれば、短期売上だけで採算を判定できません。
管理表には、顧客別売上と処理原価に加え、狭い分野への反復度、複数アカウントの同期、本人確認の確度、規約違反の調査費を置きます。
通常の大口顧客まで抑えないよう、利用量だけで自動停止せず、行動パターンと契約目的を組み合わせます。
防御費も一社のセキュリティ予算だけでは閉じません。
集約業者経由の売上を残すほど顧客の出どころは見えにくくなり、本人確認を強めるほど販売転換率は下がります。
直接販売の粗利、間接販売の手数料、悪用調査、人の再審査、誤停止による解約を同じ案件収支へ入れる必要があります。
AIを買う企業にも関係します。
別会社のAI出力で社内モデルを訓練する場合は、契約上の許諾と生成物の利用範囲を確認します。
自社の機密データを外部モデルへ送る場合は逆に、保持期間、学習利用、再委託先、ログの所在を確認し、能力を作る材料がどちらへ流れるかを把握します。
米中が争っているのは、技術ではなく境界線である
米国側と中国側は、蒸留そのものが正当な用途を持つ点では一致しています。 米勧告は合法的で有用な技術だと認めた上で、規約と地域制限を避けた組織的抽出を悪質としました。
中国商務部は9月9日、蒸留は各社が使う一般的な手段で、米側が商業問題を政治化していると反論しました。
米勧告は、中国政府が認識していた可能性が高いと評価しています。
しかし、公開版はその判断に使った情報の全体を示していません。
企業の検知結果は具体的でも、誰の指示で行われたか、どの回答がどのモデルの能力へ移ったかは、外部から完全には再現できません。
Googleの2月の脅威報告は、世界の民間主体や研究者によるモデル抽出を検知した一方、2025年中に追跡対象の国家系攻撃者や情報工作主体がフロンティアモデルを直接攻撃した事例は確認していないとしました。
これは9月の勧告を否定する材料ではありません。
対象期間、主体、モデル、直接攻撃の定義が違うため、確認できた範囲を狭く保つ材料です。
見立てと監視ポイント
- 勧告から執行へ進むか — 名指しされた企業への制裁、アクセス規制、訴訟、正式な技術対話のどれが続くかを見ます。勧告だけなら強制力は限定されます。
- 提供会社の利用条件と品質管理 — 本人確認、集約業者への条件、利用上限、疑わしい利用への回答変更が規約に明記されるか。正規顧客への誤判定率も重要です。
- 検証可能な証拠の範囲 — アカウント数や問い合わせ量に加え、帰属方法、時系列、他社との相関がどこまで公開されるかを追います。生ログを出せない場合も、独立監査の有無が判断材料になります。
腹落ち確認の問い
正当な知識蒸留と、能力を抜き取る蒸留攻撃を分けるには、問い合わせ内容以外に何を確認すべきでしょうか。
考え方
一問の内容ではなく、許諾、利用目的、規模、反復性、アカウント間の同期、地域制限や本人確認を避けた痕跡を組み合わせます。
大量利用だけで決めると正規顧客を止め、規約違反だけで決めると技術的な被害を測れません。
契約上の境界と、訓練データを作る行動パターンの両方が必要です。
もっと詳しく知りたい人へ
- 一次情報: NSA・CISA・FBIの共同勧告 — 帰属主張、アクセス経路、検知指標、緩和策を18ページで確認できます
- 提供企業の一次情報: Anthropicの検知報告 — 1600万回超、約2万4000アカウントという会社側の観測と対策が分かります
- 提供企業の一次情報: Google Threat Intelligence Groupの報告 — 世界的なモデル抽出の観測と、国家系主体について確認できなかった範囲を読めます
- 技術標準: NIST AI 100-2e2025 — 敵対的機械学習の用語、攻撃類型、緩和策の土台を確認できます
- 反対当事者の一次情報: 中国商務部の2026年9月9日付回答 — 米側の帰属と問題設定に対する中国政府の公式反論を読めます
- 関連する業界の見取り図: 情報・通信業業界基礎ガイド — API型サービスを含む情報通信業の収益・費用構造を確認できます
出典(一次/二次の切り分け)
一次で照合したもの
- NSA・CISA・FBIの2026年9月8日付共同勧告とNSA発表 — 6社、対象モデル、期間、規模、経路、検知指標、三つの即時対応、MITRE ATLAS・NISTに基づく緩和策。
- AnthropicとGoogleの公式脅威報告 — 提供企業が観測した件数、アカウント群、対象能力、防御策、観測できなかった主体の範囲。
- NIST AI 100-2e2025 — 敵対的機械学習の分類と緩和策。個別企業への帰属を裏付ける資料ではありません。
- 中国商務部の2026年9月9日付回答 — 米側の主張への否定、蒸留を中性技術とする中国側の説明、対抗措置の可能性。
独立確認に使ったもの
- APとReutersの2026年9月8〜9日付報道 — 勧告の発表日、米側の主張、中国側の反論、米中対話を控えた時系列を確認しました。
反証で残った限界
- 具体的な企業帰属、能力移転の効果、中国政府の認識は米機関・提供企業の評価です。公開資料だけでは生ログと情報源の全体を独立再現できず、違法性を確定する司法判断も示されていません。