医師の判断は最大18ポイント改善、それでも実地導入へはもう一段ある — 3か国249人試験が示した医療AIの境界
【科学・ライフサイエンス】連載・AI・イノベ【科学・AI】グローバル(複数横断)【経済・医療介護】
#医療AI#臨床意思決定支援#LLM#GPT-4o#無作為化比較試験#医療の質#患者安全#AI実装
目次
医師の判断は最大18ポイント改善、それでも実地導入へはもう一段ある — 3か国249人試験が示した医療AIの境界
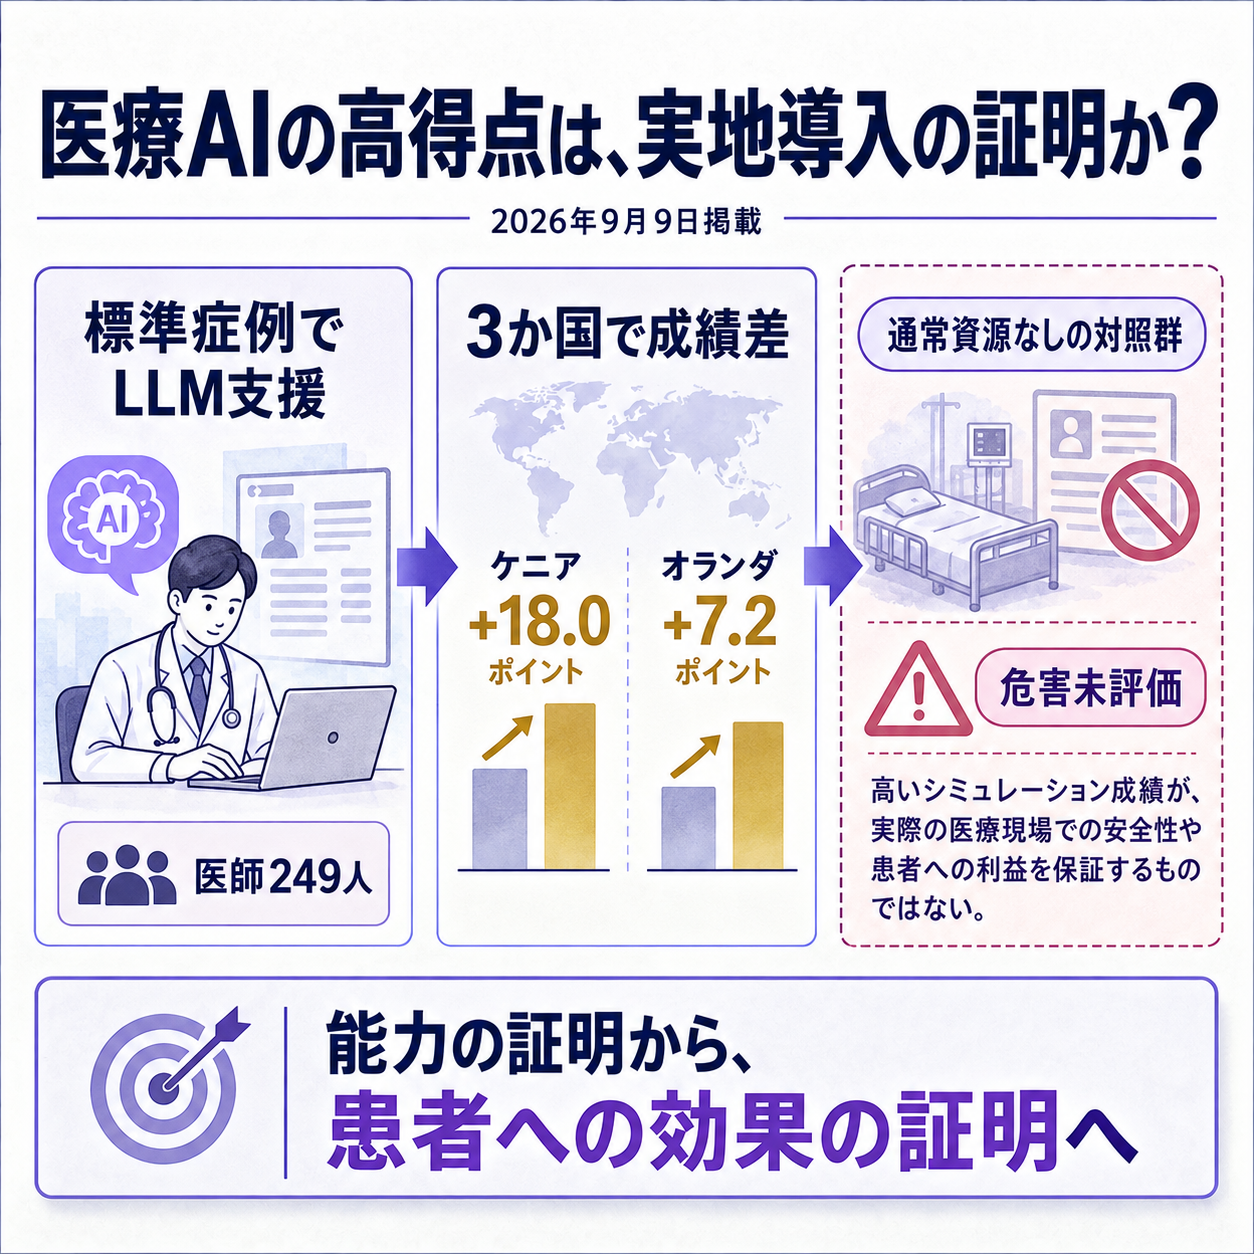
医師が大規模言語モデルを使うと、紙の症例に対する判断の点数は3か国すべてで上がりました。ただし、そのまま病院の現場へ置けると結論づけるには、試験が測っていないものが多く残っています。
2026年9月9日、npj Digital Medicineに、インドネシア、ケニア、オランダの医師を対象にした無作為化比較試験が掲載されました。
参加者はGPT-4oを使える群と使えない群に分けられ、標準化された臨床ビネット(文章で示された模擬症例)への対応を採点されました。
結果は明快です。ただし対照群は、インターネットや診療ガイドラインも使えませんでした。今回見えたのは「何も参照できない医師にLLMを渡す効果」に近く、普段の道具へ足す価値とは少し違います。
249人の試験で、3か国すべてに群間差が出た
対象は249人です。
医師は単純無作為化で介入群と対照群へ割り付けられ、介入群だけがGPT-4oへアクセスできました。
診断だけでなく、追加で何を聞き、どの検査を考え、どう管理するかを含む臨床パフォーマンスが評価されています。
LLMを使える群と使えない群の差は、ケニアで18.0パーセントポイント、インドネシアで10.7ポイント、オランダで7.2ポイントでした。いずれも統計的に有意で、最も差が大きかったのはケニアです。
この並びから「医療資源が少ない国ほどAIが効く」とは言い切れません。
医師の経験、普段の情報環境、症例への慣れ、介入前の成績も国ごとに違うためです。
格差縮小の可能性は示しますが、その原因まで特定した試験ではありません。
用語の補足
- 無作為化比較試験 — 参加者を偶然に介入群と対照群へ分け、背景の偏りを減らして効果を比べる方法です。
- 臨床ビネット — 症状や検査結果を文章で示した模擬症例です。条件をそろえやすい一方、実際の患者との会話や時間制約は再現しきれません。
- パーセントポイント — 割合どうしの差を示す単位です。例えば50%から68%への上昇は18ポイントです。
強い結果を生んだ試験条件が、そのまま限界でもある
この試験の強みは、同じ形式の症例と採点基準で国をまたいで比較したことです。
患者の重症度、病院の設備、診療報酬といった現場の違いをいったん外し、LLMへアクセスできること自体の影響を見やすくしています。
同じ設計が、実装判断では注意点になります。
対照群はインターネットも診療ガイドラインも使えませんでした。
現場の比較相手は、通常なら検索、電子カルテ、院内手順書、同僚への相談を使える医療者です。
したがって、調達時に必要なのは「LLM対何もなし」の差ではなく、「現在の標準業務対標準業務+LLM」の上乗せです。
もう一つ大きいのが、研究者自身が明記した「危害を評価していない」という点です。
採点が上がっても、もっともらしい誤答を医師が採用する頻度、見逃し、不要な検査、薬の過剰処方が増えれば、患者に届く価値は変わります。
統制された症例での成績は、効果の入口であって、安全な運用の出口ではありません。
症例の点数と患者の転帰は、別の段で測る
この境界をよく示すのが、2026年にNature Medicineへ掲載された別の実地試験です。
ケニアの16施設で、電子カルテに組み込んだLLM支援を臨床担当者103人へ割り付け、実際の患者を追いました。
一次解析は9,347件です。
診療記録では、診断の適切さ、記載の網羅性、治療計画の質が改善しました。
しかし、主要評価項目だった14日以内の治療失敗は、対照群2.0%、介入群2.2%で、統計的に有意な減少は確認されませんでした。
記録と判断の質が上がることと、再受診や救急への移行などが減ることは、同じではありません。
両試験は対象者も設計も異なり、片方で片方を否定できません。並べて分かるのは、模擬症例の能力、現場での利用、診療過程、患者の転帰と安全性を一段ずつ測る必要があることです。
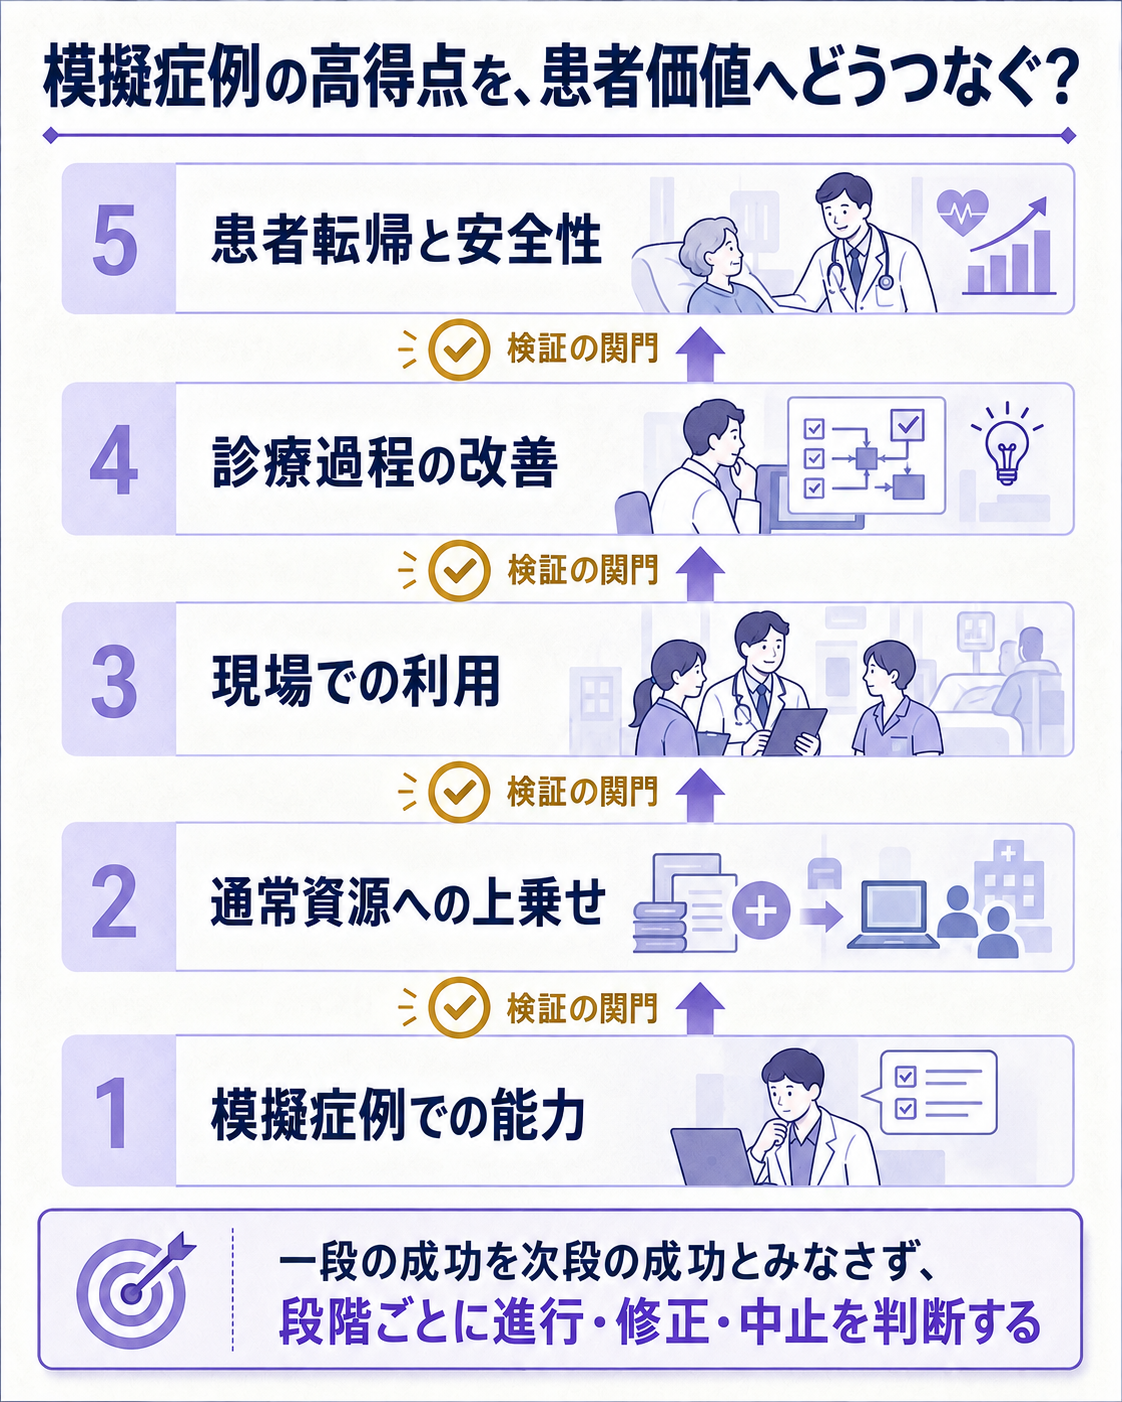
この順番なら「論文で有意差が出た」ことを、全面導入の許可証ではなく、次の試験へ進む根拠として扱えます。
逆に、最初から患者の死亡や入院だけを主要指標にすると、まれな事象を検出するために非常に大きな標本が必要になり、小さな試行では判断できません。
近い指標と遠い指標を両方持つことが要ります。
安全性は平均点ではなく、誤りが流れた経路を見る
同じケニアの診療網を調べた別のNature Health研究では、LLMを使った診療記録から抽出した1,469件を専門家が見直しました。
LLMの助言のうち、積極的に有害になり得るものは7.8%にあり、その一部に当たる67件は最終記録にも残っていました。
これは抽出記録を後から調べた研究で、全利用例の危害発生率を示す数字ではありません。それでも「医師が間にいるから安全」とは限りません。最後は、人とAIの判断の受け渡し方が成否を分けます。
導入時には、AI単体の正答率だけでなく、助言を採用・修正・却下した割合を残します。
重大な助言ほど二人目の確認へ回す、使える薬や紹介先を地域の実情に合わせる、誤りが出た症例を次の版でも再試験する、といった運用が必要です。
モデル更新で挙動が変わるため、一度の承認で検証を終えることもできません。
安い利用料だけでは、導入費用を測れない
Nature Medicineの実地試験で計算されたモデル利用料は、患者1件当たり0.04ドルでした。
ただし、これは生成したトークンに単価を掛けた費用です。
電子カルテとの接続、個人情報の除去、医師への教育、専門家による監査、事故対応、再検証の費用は含みません。
予算を組むなら、モデル利用料と実装・統制費を分けます。
試行段階では対象診療科、利用件数、期間を限定し、診療記録の質だけでなく、不要検査、処方の適切さ、再受診、重大事象、医師の修正率を追います。
次段へ進む条件と止める条件を先に決めれば、精度が高かったという一つの数字だけで範囲が広がるのを防げます。
効果も平均だけでは足りません。
経験年数、施設、疾患、言語別に誤りが偏れば、全体点が上がっても一部の患者には悪化が残ります。
国ごとの差が今回の論点になったからこそ、導入先の患者と診療手順で再現することが欠かせません。
見立てと監視ポイント
- 通常業務への上乗せ効果 — 比較相手が「何も使えない医師」ではなく、検索、ガイドライン、同僚相談を含む現在の標準業務になっているかを見ます。
- 近い指標から患者転帰への接続 — 症例得点や記録品質の改善が、処方の適切さ、再受診、入院、重大事象へつながるかを段階別に確認します。
- 誤りの採用経路と版管理 — 誤答率だけでなく、医療者が採用したか、誰が止めたか、モデル更新後にも同じ症例を通過できるかを追います。
腹落ち確認の問い
模擬症例の成績が大きく改善した一方、実地試験で患者の治療失敗が減らなかったとき、導入の可否を一つの指標で決めないためには、どんな順番で条件を置けばよいでしょうか。
考え方
まず通常資源へLLMを足した上乗せを測り、次に現場で実際に使われた割合と診療過程の質を確認します。
そのうえで再受診や有害事象など患者側の指標を追い、重大な誤りが出た場合の停止条件を置きます。
前の段を通ったことを次の段の成功とみなさず、各段に進行・修正・中止の基準を持たせるのが要点です。
もっと詳しく知りたい人へ
- 一次論文: npj Digital Medicineの3か国無作為化比較試験 — 249人の研究設計、国別の群間差、危害未評価という限界を確認できます
- 研究背景: ILOの公式解説 — なぜ労働・医療資源の違いをまたいで試験したのかが分かります
- 実地での反証材料: Nature Medicineのケニア実地RCT — 記録品質は改善しても14日以内の治療失敗は減らなかった結果を読めます
- 安全性の確認: Nature Healthの実診療記録研究 — 有害になり得る助言が医師の判断をどう通過したかを追えます
- 別設計の比較: Nature Healthの医師向けLLM支援RCT — 20時間のAIリテラシー研修と通常の情報源を組み合わせた試験を比較できます
- 関連する業界の見取り図: サービス業業界基礎ガイド — 人が提供するサービスで品質、稼働、標準化をどう見るかの基礎を確認できます
出典(一次/二次の切り分け)
一次で照合したもの
- npj Digital Medicineの2026年9月9日付論文 — 3か国249人、割付条件、国別の群間差、危害未評価、統制された模擬症例であることを確認しました。
- Nature Medicineの実地RCT — ケニア16施設、臨床担当者103人、一次解析9,347件、治療失敗と診療記録品質の結果、モデル利用料の範囲を確認しました。
- Nature Healthの安全性研究 — 対象記録数、有害になり得る助言、最終記録への反映、後ろ向き研究という設計を確認しました。
反証で残った限界
- 3か国試験はインターネットや診療ガイドラインも使えない対照群との比較で、危害を評価していません。国別の差は医療資源だけでなく参加者構成や開始時点の成績にも左右されます。別の実地研究は対象者、システム、評価項目が異なるため、効果の否定ではなく、証拠を次段へ進める必要性の確認に使いました。